字符设备驱动解析
字符设备驱动编写思路
对于一个应用程序想要去调用底层的某个设备驱动,肯定是需要使用系统调用read,write,ioctl等操作,而如read操作在进入内核后调用的sys_read函数,并在最终的vfs_read中调用当前struct file指针内部对应的fops里面驱动开发者编写的read函数
所以我们就需要向内核提供我们当前字符驱动的file_operations结构体,将它注册进入全局的char_device数组中,以便内核能够找到;除此以外为了应用程序能够找到我们还需要创建一个主设备号对应的设备节点,以及从设备号对应的子设备 ,这样应用程序才能在/sys等地方找到
旧版字符设备驱动编写
static struct file_operations myCharDev_fops = {
    .owner = THIS_MODULE,
    .read  = myCharDev_read,
    .write = myCharDev_Write,
    .open = myCharDev_open,
};

static int __init initCharDev(void)
{
    int major = 0;
    //注册file_operations
    major = register_chrdev(major, "myChardev", &myCharDev_fops);
    //创建主设备号和对应的设备节点
    major_class = class_create(THIS_MODULE, "mycharDev");
    //创建子设备节点
    minor_class = class_device_create(major_class,NULL,MKDEV(major, 0),NULL,"myCharDev0");

    return 0;
}

module_init(initCharDev);
module_exit(exitCharDev);
MODULE_LICENSE("GPL");这里的设备驱动编写方式,一个主设备对应有很多个从设备,但是一个file_operations只能对应一个主设备,从设备没有自己的file_operations
register_chrdev让major主设备号对应的从设备号(0~255)都用一个file_operations
新版字符设备驱动编写
注册字符设备
    int ret;
    dev_t devno = MKDEV(major, 0);

    //如果不是第一次创建
    if(major)
    {
        ret = register_chrdev_region(devno, MINORCNT, "mychardev");
    }
    //第一次创建
    else {
        ret = alloc_chrdev_region(&devno, 0, MINORCNT, "mychardev");
        major = MAJOR(devno);
    }
和旧版的register_chrdev不同,这里使用的alloc_chrdev_region和register_chrdev_region可以按需注册指定数量的次设备号
它们在底层都是调用的同一个函数:__register_chrdev_region
char_device_struct结构体
在正式查看__register_chrdev_region函数之前我们先来查看一下char_device_struct结构体 ,了解内核是如何管理字符驱动设备的
// fs/char_dev.c
static struct char_device_struct {
    struct char_device_struct *next;
    unsigned int major;
    unsigned int baseminor;
    int minorct;
    char name[64];
    struct cdev *cdev;        /* will die */
} *chrdevs[CHRDEV_MAJOR_HASH_SIZE];可以首先看到这个结构体的声明之后,创建了一个*chrdevs[CHRDEV_MAJOR_HASH_SIZE]数组,这是一个char_device_struct结构体指针数组,其中CHRDEV_MAJOR_HASH_SIZE数值是255;注意这里并不是代表着内核只能管理255个主设备号,仔细看宏定义可以看到这里的是HASH
这个全局的chrdevs本质上是一个哈希表
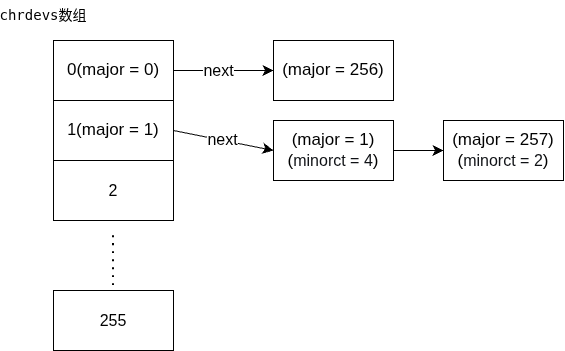
chrdevs[0] -> struct char_device_struct (major=0, baseminor=0, minorct=4)
               |
               next -> struct char_device_struct (major=256, baseminor=0, minorct=2)
               |
               next -> ...

chrdevs[1] -> struct char_device_struct (major=1, baseminor=0, minorct=1)
               |
               next -> ...

...

chrdevs[255] -> ...数组中每一个元素都是一个哈希桶,作为一个链表头
这样我们在看回char_device_struct的定义:
next指针有两个用途:
- 处理哈希冲突:同一个哈希桶里有多个不同的主设备号时,通过
next串联起来 - 处理同一个主设备号下的多次注册:如果你对同一个主设备号调用多次
register_chrdev_region(),每次会创建一个新的struct char_device_struct,通过next串在同一个主设备号的链表上
major是主设备号baseminor是次设备号起始处minorct代表本次有多少个次设备name是设备名cdev为实际的设备管理结构体,后续解析
__register_chrdev_region
// fs/char_dev.c
/*
 * Register a single major with a specified minor range.
 *
 * If major == 0 this function will dynamically allocate an unused major.
 * If major > 0 this function will attempt to reserve the range of minors
 * with given major.
 *
 */
static struct char_device_struct *
__register_chrdev_region(unsigned int major, unsigned int baseminor,
               int minorct, const char *name)
{
    struct char_device_struct *cd, *curr, *prev = NULL;
    int ret;
    int i;

    if (major >= CHRDEV_MAJOR_MAX) {
        pr_err("CHRDEV \"%s\" major requested (%u) is greater than the maximum (%u)\n",
               name, major, CHRDEV_MAJOR_MAX-1);
        return ERR_PTR(-EINVAL);
    }

    if (minorct > MINORMASK + 1 - baseminor) {
        pr_err("CHRDEV \"%s\" minor range requested (%u-%u) is out of range of maximum range (%u-%u) for a single major\n",
            name, baseminor, baseminor + minorct - 1, 0, MINORMASK);
        return ERR_PTR(-EINVAL);
    }

    cd = kzalloc(sizeof(struct char_device_struct), GFP_KERNEL);
    if (cd == NULL)
        return ERR_PTR(-ENOMEM);

    mutex_lock(&chrdevs_lock);

    if (major == 0) {
        ret = find_dynamic_major();
        if (ret < 0) {
            pr_err("CHRDEV \"%s\" dynamic allocation region is full\n",
                   name);
            goto out;
        }
        major = ret;
    }

    ret = -EBUSY;
    i = major_to_index(major);
    for (curr = chrdevs[i]; curr; prev = curr, curr = curr->next) {
        if (curr->major < major)
            continue;

        if (curr->major > major)
            break;

        if (curr->baseminor + curr->minorct <= baseminor)
            continue;

        if (curr->baseminor >= baseminor + minorct)
            break;

        goto out;
    }

    cd->major = major;
    cd->baseminor = baseminor;
    cd->minorct = minorct;
    strlcpy(cd->name, name, sizeof(cd->name));

    if (!prev) {
        cd->next = curr;
        chrdevs[i] = cd;
    } else {
        cd->next = prev->next;
        prev->next = cd;
    }

    mutex_unlock(&chrdevs_lock);
    return cd;
out:
    mutex_unlock(&chrdevs_lock);
    kfree(cd);
    return ERR_PTR(ret);
}
参数校验
    if (major >= CHRDEV_MAJOR_MAX) {
        pr_err("CHRDEV \"%s\" major requested (%u) is greater than the maximum (%u)\n",
               name, major, CHRDEV_MAJOR_MAX-1);
        return ERR_PTR(-EINVAL);
    }

    if (minorct > MINORMASK + 1 - baseminor) {
        pr_err("CHRDEV \"%s\" minor range requested (%u-%u) is out of range of maximum range (%u-%u) for a single major\n",
            name, baseminor, baseminor + minorct - 1, 0, MINORMASK);
        return ERR_PTR(-EINVAL);
    }
分配char_device_struct结构体
    cd = kzalloc(sizeof(struct char_device_struct), GFP_KERNEL);
    if (cd == NULL)
        return ERR_PTR(-ENOMEM);
寻找空闲主设备号(第一次注册)
如果当前是第一次注册这个字符型设备驱动,那么major传入的值为0,会进入下面这个if语句去寻找一个空闲的主设备号
    if (major == 0) {
        ret = find_dynamic_major();
        if (ret < 0) {
            pr_err("CHRDEV \"%s\" dynamic allocation region is full\n",
                   name);
            goto out;
        }
        major = ret;
    }
find_dynamic_major定义如下:
static int find_dynamic_major(void)
{
    int i;
    struct char_device_struct *cd;

    for (i = ARRAY_SIZE(chrdevs)-1; i >= CHRDEV_MAJOR_DYN_END; i--) {
        if (chrdevs[i] == NULL)
            return i;
    }

    for (i = CHRDEV_MAJOR_DYN_EXT_START;
         i >= CHRDEV_MAJOR_DYN_EXT_END; i--) {
        for (cd = chrdevs[major_to_index(i)]; cd; cd = cd->next)
            if (cd->major == i)
                break;

        if (cd == NULL)
            return i;
    }

    return -EBUSY;
}
这个函数使用了两个循环,笔者最开始对于这几个宏定义没有看懂为什么,后续询问AI才知道大致意思如下:
根据内核文档(Documentation/admin-guide/devices.txt)和代码约定,主设备号被划分为以下几个区域:
| 主设备号范围 | 用途 | 对应宏 |
|---|---|---|
| 0 ~ 233 | 静态/遗留保留区 (如 1=mem, 4=tty, 6=lp, 8=scsi 等) | 完全不扫描 |
| 234 ~ 254 | 传统 8 位动态区 (可供 alloc_chrdev_region 分配) | CHRDEV_MAJOR_DYN_END = 234(循环从 254 向下到 234) |
| 255 | 通常保留给实验/本地使用 | (部分版本会包含在上一区) |
| 256 ~ 383 | 特定用途/扩展保留区 (例如 256-259 常分配给 pty 从设备等) | 第二个循环跳过 |
| 384 ~ 511 | 扩展 12 位动态区 (供 alloc_chrdev_region 分配的高端号) | CHRDEV_MAJOR_DYN_EXT_END = 384CHRDEV_MAJOR_DYN_EXT_START = 511(循环从 511 向下到 384) |
所以,内核并不是“从 0 开始找空闲”,而是“只在安全的空地上找”。
因此分两次查找,首先查找传统动态区是否还有空闲的major
for (i = ARRAY_SIZE(chrdevs)-1; i >= CHRDEV_MAJOR_DYN_END; i--) {
     if (chrdevs[i] == NULL)
         return i;
}ARRAY_SIZE(chrdevs)是 255(哈希桶数量)。- 这里
i既代表哈希桶索引,也代表主设备号(因为 234~254 都小于 255,major % 255 = major,没有哈希冲突)。 - 所以直接检查
chrdevs[i] == NULL就能确定这个主设备号是否空闲。简单高效。
然后第二段循环(遍历链表)
for (i = CHRDEV_MAJOR_DYN_EXT_START; i >= CHRDEV_MAJOR_DYN_EXT_END; i--) {
     for (cd = chrdevs[major_to_index(i)]; cd; cd = cd->next)
     {
         if (cd->major == i)
             break;
         if (cd == NULL)
             return i;
     }

}- 这里的
i范围是 384 ~ 511,大于 255。 - 调用
major_to_index(i)后,因为取模运算(i % 255),多个不同的主设备号会映射到同一个哈希桶(例如 384 % 255 = 129, 129 % 255 = 129,会冲突)。 - 所以不能只看哈希桶是否为空,必须遍历该桶下的链表
cd->next,逐个比较cd->major == i,才能确认这个特定的主设备号i是否真的空闲。
区间重叠检测
在上面获取得到一个主设备号之后,接下来需要查看要注册的次设备区间是否与当前已经注册好的重叠
    ret = -EBUSY;
    i = major_to_index(major);
    for (curr = chrdevs[i]; curr; prev = curr, curr = curr->next) {
        if (curr->major < major)
            continue;

        if (curr->major > major)
            break;

        if (curr->baseminor + curr->minorct <= baseminor)
            continue;

        if (curr->baseminor >= baseminor + minorct)
            break;

        goto out;
    }
等价于:
检查新区间 [baseminor, baseminor+minorct)
是否与已有区间 [curr->baseminor, curr->baseminor+curr->minorct) 重叠


新区间: [A, A+lenA)
旧区间: [B, B+lenB)

不重叠的条件:A+lenA <= B OR B+lenB <= A
重叠的条件:A+lenA > B AND B+lenB > A因为链表是按 major 排序的(从小到大),所以:
curr->major < major→ 继续往后找curr->major > major→ 说明后面的 major 都更大,直接 break
如果4个if语句都没有执行,那么就说明当前区间和要注册的区间重叠了,直接执行out标签的清理工作
将新区间放入哈希链表
    cd->major = major;
    cd->baseminor = baseminor;
    cd->minorct = minorct;
    strlcpy(cd->name, name, sizeof(cd->name));

    if (!prev) {
        cd->next = curr;
        chrdevs[i] = cd;
    } else {
        cd->next = prev->next;
        prev->next = cd;
    }
接下来就是将新的区间放进去全局的哈希链表中,这里是一个链表的中间插入操作
在上面的区间重叠检测中,通过for循环后,我们将把新的区间插入prev和curr之间
if (!prev)表示prev为空,根据前面for循环可知道,这里的意思就是当前这块链表为空,cd就是这个链表的头节点
返回char_device_struct
在最后解开互斥锁然后返回cd
自定义类型结构体
typedef struct chrdevMem{
    struct cdev cdev;
    uint8_t mem[MEMSIZE];
} chrdevMem_t;这里笔者为这个简单的字符设备驱动创建了一个结构体封装,将它相关的所有数据都封装进入一个struct chrdevMem里面作为一种面向对象的思想
结构体只含有两个成员:
cdev:用于管理次设备的struct cdev结构体mem:用于存储设备私有数据的数组
file_operations结构体
static struct file_operations myCharDev_fops = {
    .owner = THIS_MODULE,
    .read  = myCharDev_read,
    .write = myCharDev_Write,
    .open = myCharDev_open,
    .llseek = myCharDev_llseek,
    .unlocked_ioctl = mychardev_unlocked_ioctl,
    .release = myCharDev_release,
};和旧版驱动一样需要为驱动设备提供一个相应的file_operations结构体
setup当前驱动的cdev
static void Setup_myChrdev_cdev(chrdevMem_t *dev,int minor)
{
    int error;
    dev_t devno = MKDEV(major,minor);

    cdev_init(&dev->cdev,&myCharDev_fops);
    dev->cdev.owner = THIS_MODULE;

    error = cdev_add(&dev->cdev, devno, MINORCNT);
    if(error)
    {
        printk(KERN_NOTICE"ERROR %d adding chrDev %d\n",error,minor);
    }

}
这个函数主要作用就是对cdev进行初始化,每个 struct cdev 可以对应一个或多个次设备号(通过 cdev_add() 时指定范围),但通常一个 cdev 管理一个次设备号。
这里代码是一次性让一个cdev管理MINORCNT个次设备
cdev_init
/**
 * cdev_init() - initialize a cdev structure
 * @cdev: the structure to initialize
 * @fops: the file_operations for this device
 *
 * Initializes @cdev, remembering @fops, making it ready to add to the
 * system with cdev_add().
 */
void cdev_init(struct cdev *cdev, const struct file_operations *fops)
{
    memset(cdev, 0, sizeof *cdev);
    INIT_LIST_HEAD(&cdev->list);
    kobject_init(&cdev->kobj, &ktype_cdev_default);
    cdev->ops = fops;
}该函数用于初始化一个cdev结构体,主要是初始化它的链表以及kobj ,然后将cdev->ops指向fops
cdev_add
/**
 * cdev_add() - add a char device to the system
 * @p: the cdev structure for the device
 * @dev: the first device number for which this device is responsible
 * @count: the number of consecutive minor numbers corresponding to this
 *         device
 *
 * cdev_add() adds the device represented by @p to the system, making it
 * live immediately.  A negative error code is returned on failure.
 */
int cdev_add(struct cdev *p, dev_t dev, unsigned count)
{
    int error;

    p->dev = dev;
    p->count = count;

    if (WARN_ON(dev == WHITEOUT_DEV))
        return -EBUSY;

    error = kobj_map(cdev_map, dev, count, NULL,
             exact_match, exact_lock, p);
    if (error)
        return error;

    kobject_get(p->kobj.parent);

    return 0;
}
cdev_add() 函数的核心作用,就是将字符设备对象(cdev)正式“挂载”到内核的全局查找表中。完成这一步后,当用户程序打开这个设备文件时,内核才能根据设备号(dev_t)找到对应的 cdev,从而调用你写的 read/write 等函数。
1.首先将设备号范围和数量保存到结构体内部,这样内核其他地方即知道这个cdev管理了哪些设备号
2.然后使用kobj_map向内核全局映射表注册
cdev_map:内核中维护的一个全局哈希表(实际上是kobj_map结构体),专门用于字符设备驱动的查找。你可以把它理解为内核的“字符设备黄页”。- 映射逻辑:调用后,内核会记录下 “设备号
dev到dev+count-1这一段区间,都对应你传入的cdev指针p”。 exact_match和exact_lock:这是两个回调函数。当内核通过设备号查找时,exact_match用于精确验证找到的cdev是否匹配(防止哈希冲突),exact_lock用于加锁保护。对于cdev,使用的是精确匹配模式。
3.增加父对象的引用计数:Linux 设备模型基于引用计数管理内存。cdev 结构体里内嵌了一个 kobject,而 kobject 通常有一个 parent(父设备,比如对应的 struct device)。
- 这里增加父对象的引用计数,是为了防止在驱动使用期间,父设备被意外卸载。
- 这是一种“依赖保护”机制,确保只要你的字符设备还在系统中注册着,它的“容器”(比如 PCI 设备对象)就不会因为引用计数归零而被内核释放。
自定义的fops函数
关于需要向fops填充的自定义的函数实现,这里主要说一下open函数内部:
static int myCharDev_open(struct inode *inode,struct file *file)
{
    file->private_data = (void *)mychardev_p;
    return 0;
}
在file结构体里面有一个
void *private_data;而我们每次打开设备后都会获得这个file结构体,那么就可以直接让这个私有数据指针指向我们的chrdevMem_t *mychardev_p;自己的私有数据 ,这样在后续的读写操作都可以直接拿到
    //获取设置好的文件私有数据
    chrdevMem_t *dev_p = (chrdevMem_t *)file->private_data;
作为一种面向对象的思想
ioctl命令参数
在使用ioctl的时候,有传入参数,我们可以自定义使用什么参数,但是内核也提供了参数的说明定义,所以最好是遵守内核的规范
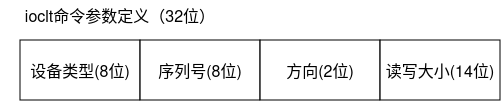
/*
 * Used to create numbers.
 *
 * NOTE: _IOW means userland is writing and kernel is reading. _IOR
 * means userland is reading and kernel is writing.
 */
#define _IO(type,nr)        _IOC(_IOC_NONE,(type),(nr),0)
#define _IOR(type,nr,size)    _IOC(_IOC_READ,(type),(nr),(_IOC_TYPECHECK(size)))
#define _IOW(type,nr,size)    _IOC(_IOC_WRITE,(type),(nr),(_IOC_TYPECHECK(size)))
#define _IOWR(type,nr,size)    _IOC(_IOC_READ|_IOC_WRITE,(type),(nr),(_IOC_TYPECHECK(size)))
#define _IOR_BAD(type,nr,size)    _IOC(_IOC_READ,(type),(nr),sizeof(size))
#define _IOW_BAD(type,nr,size)    _IOC(_IOC_WRITE,(type),(nr),sizeof(size))
#define _IOWR_BAD(type,nr,size)    _IOC(_IOC_READ|_IOC_WRITE,(type),(nr),sizeof(size))
这些宏定义都可以被我们直接使用,用来创建规范的参数
他们都是调用的_IOC宏定义:
#ifndef _IOC_NONE
# define _IOC_NONE    0U
#endif

#ifndef _IOC_WRITE
# define _IOC_WRITE    1U
#endif

#ifndef _IOC_READ
# define _IOC_READ    2U
#endif

#define _IOC(dir,type,nr,size) \
    (((dir)  << _IOC_DIRSHIFT) | \
     ((type) << _IOC_TYPESHIFT) | \
     ((nr)   << _IOC_NRSHIFT) | \
     ((size) << _IOC_SIZESHIFT))